TokenLab 产品开发故事
很久没有更新公众号了。此前的文章中,我也提到今年的工作方向有所转变,正在设计和开发一款 AI Native 产品。从 5 月 6 日 23 点 04 分提交第一批代码算起,到现在已经过去半年时间。这款产品——TokenLab,也终于要迎来它的 1.0.0 版本。
回顾这半年时间,看到图中的这些数据,也不禁感慨万千。
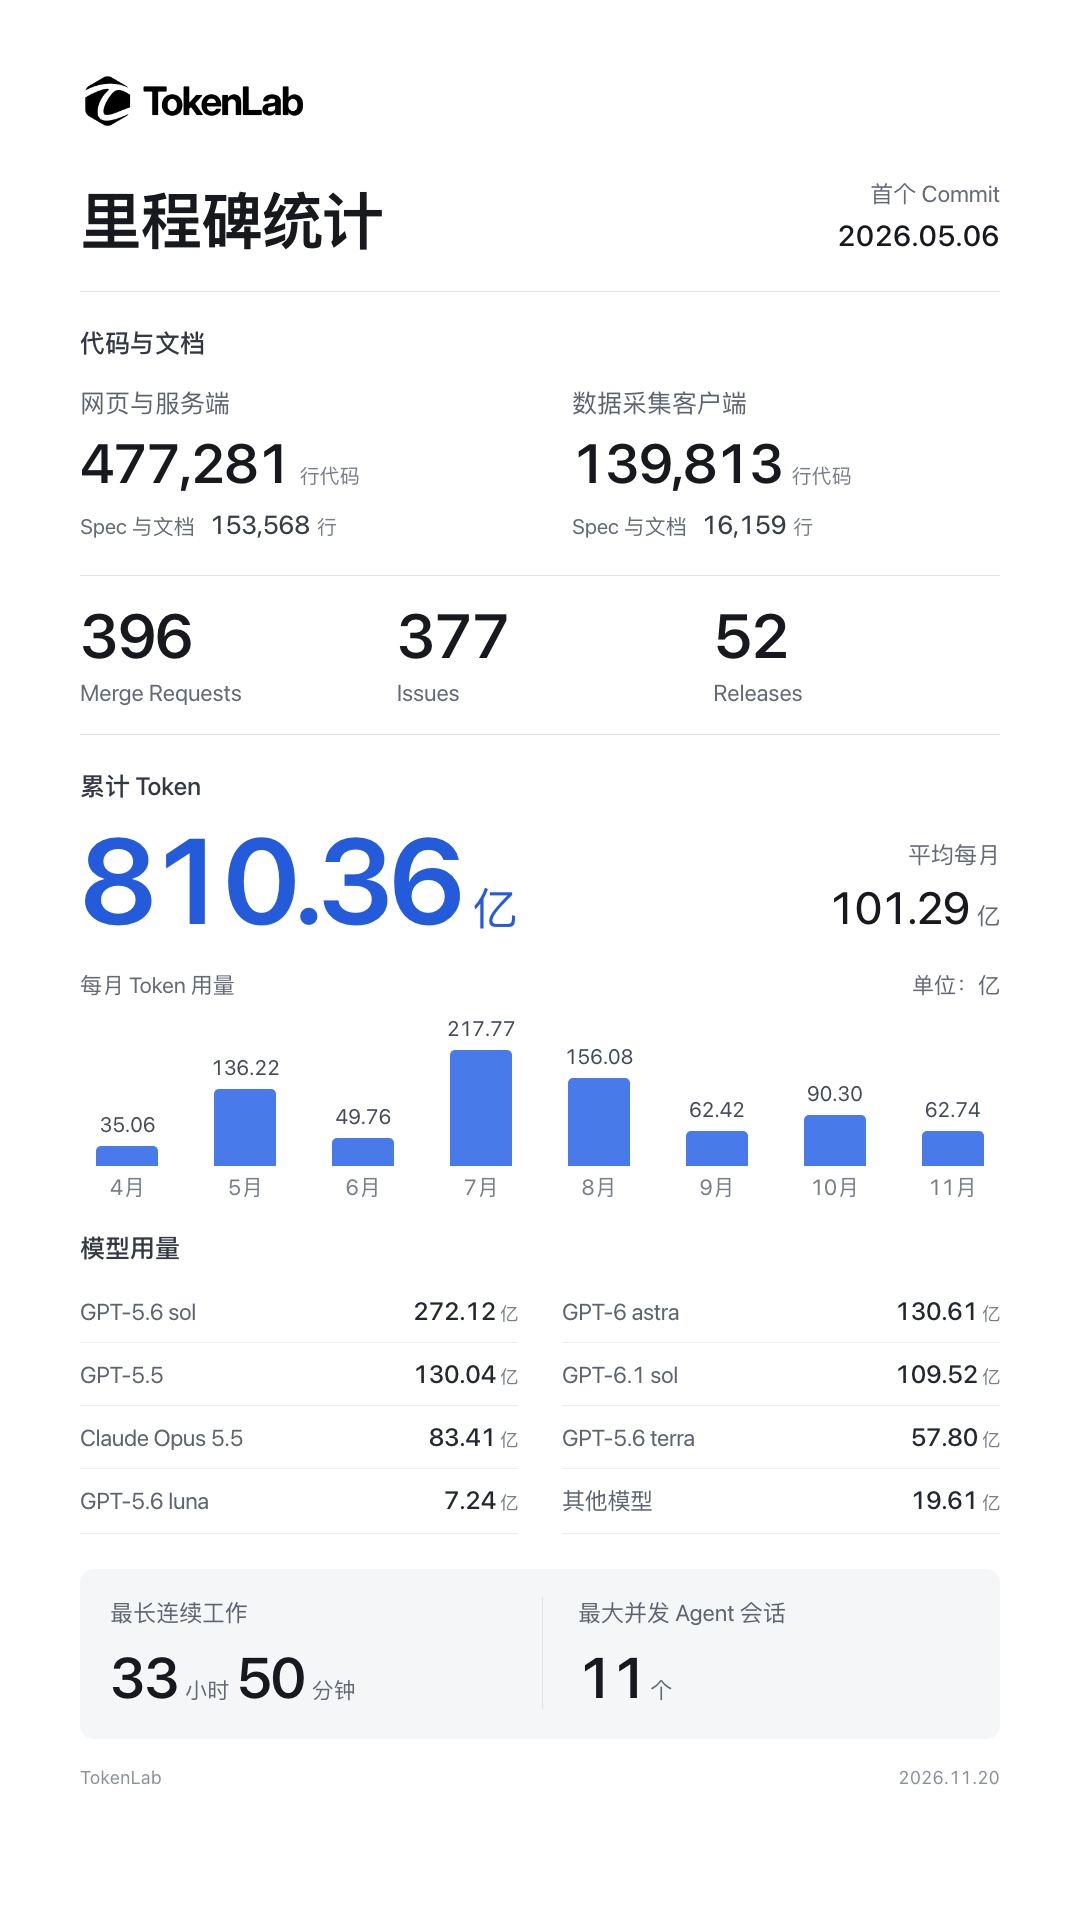
TokenLab 是什么?产品设计与开发过程中踩了哪些坑,又有哪些心得体会?趁 1.0.0 版本发布之际,我也来简单分享一下产品开发故事。
1. 产品核心价值:AI 落地风险与管控焦虑
TokenLab 的产品定位是 企业 AI(编程)治理平台,目前聚焦软件开发中的 AI 编程场景,后续会拓展到 AI 办公等更多应用场景。
TokenLab 希望解决企业在 AI 落地过程中的以下问题:
- 企业在 AI 模型服务上花了多少钱?每个部门用了多少?每个人又用了多少?
- AI 的投入是不是有明确的产出?有多少 AI 贡献的代码最终进入了生产环境?
- 使用 AI 后,代码质量和交付效率真的有提升吗?
- 企业在使用 AI 模型服务时,如何防止敏感数据外泄?
- 哪些项目、人员使用 AI 的效果好?哪些部门、人员的 AI 落地情况还有待提升?
- AI 提高了开发效率,但为什么组织整体感觉没有提效?
这些问题一直困扰着企业管理人员,并引发了各种焦虑。企业内往往同时使用多种 AI Agent 和模型服务,却缺少统一的分析手段,也难以有针对性地改进使用效果。
TokenLab 的 AI 网关模块管理模型服务调用和 Token 消耗,帮企业管好 AI、算清楚账。AI 归因模块分析 AI 在代码开发中的贡献,帮企业用好 AI、沉淀经验。当然,这期间还离不开 GitLab,它作为企业软件开发协同平台,保存了开发记录与归因数据。
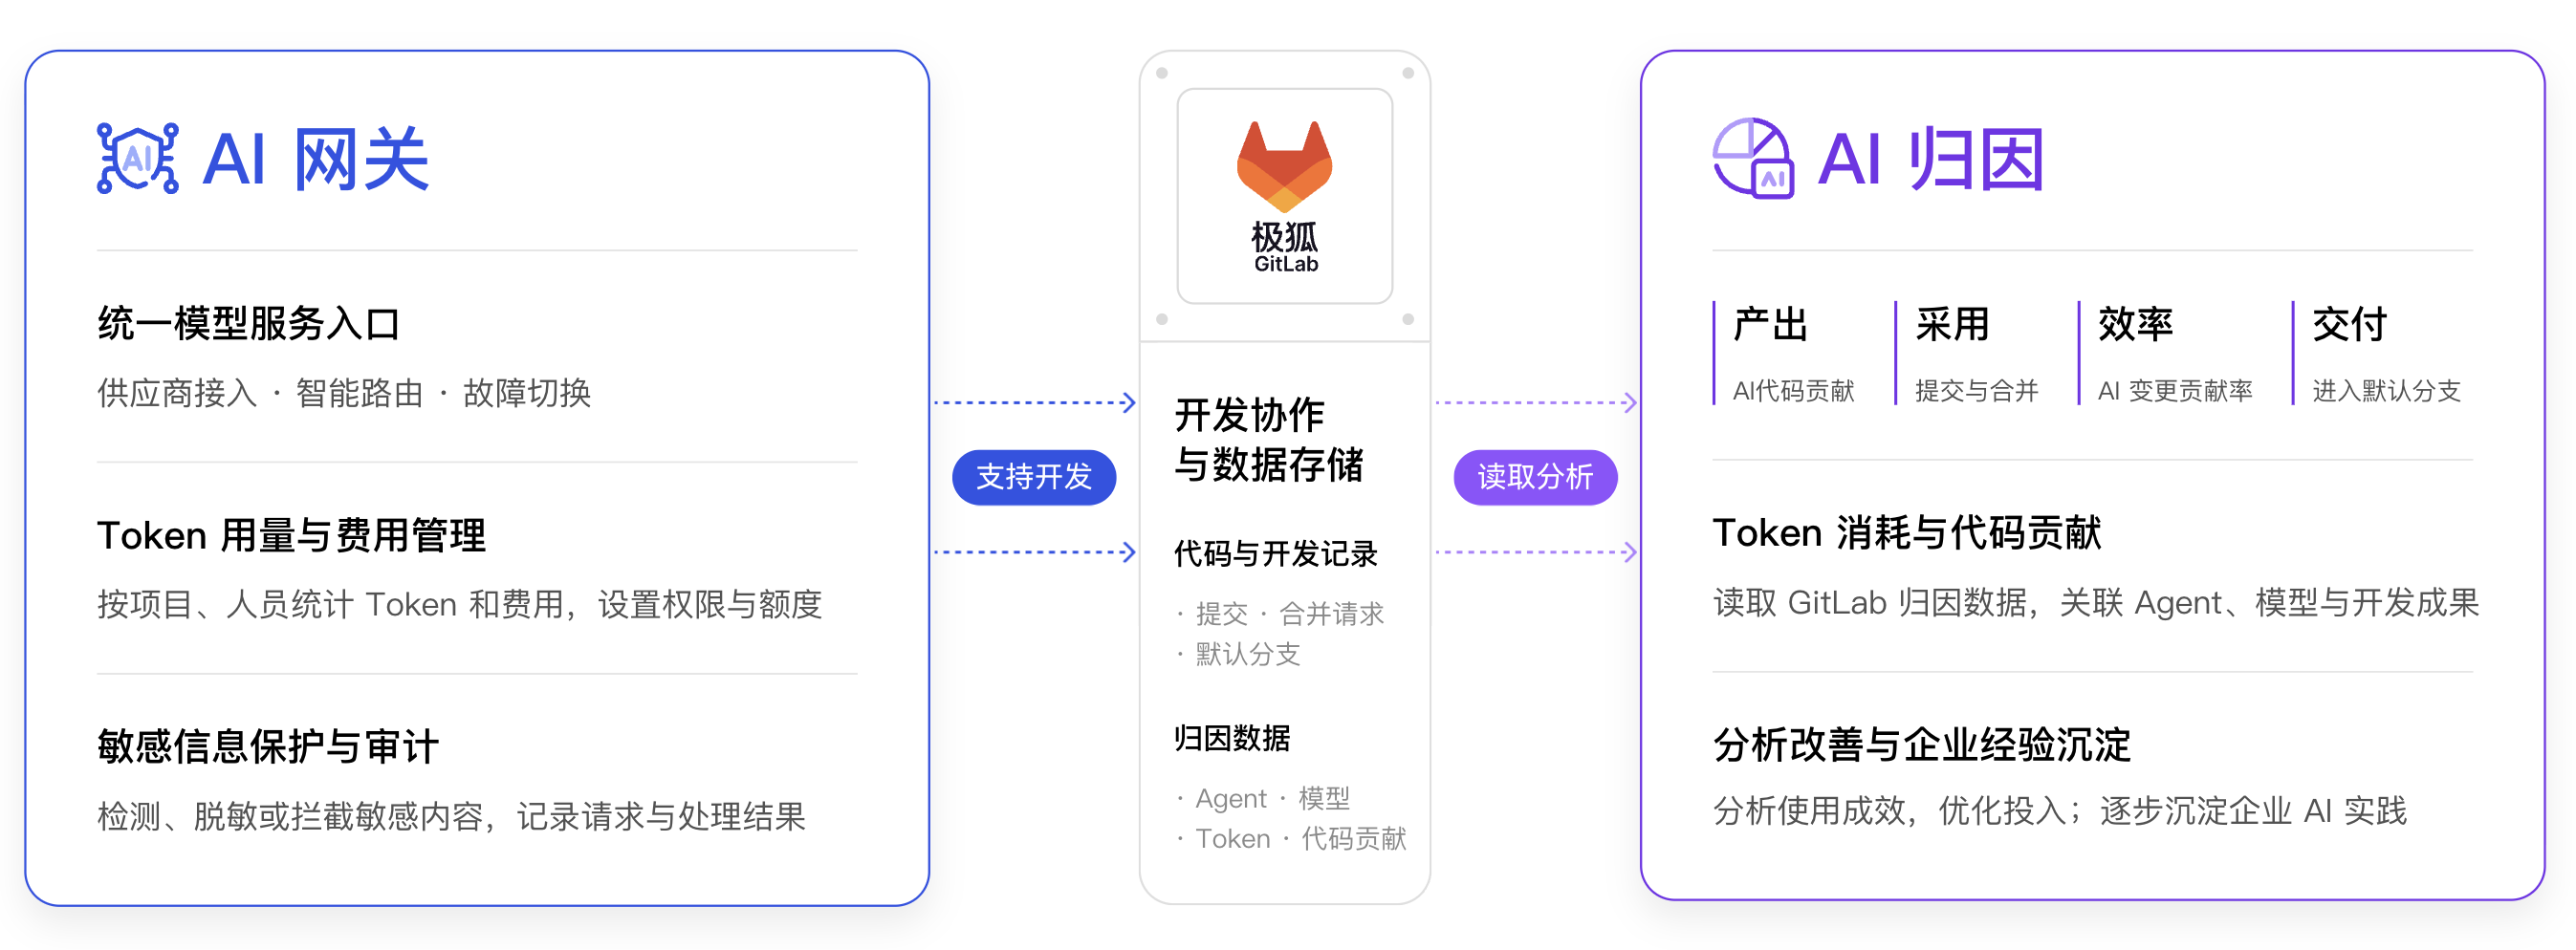
需要说明的是,TokenLab 在 AI 归因上,不是想做 AI 时代的考勤机,而是通过看整体、看对比、看分布和看趋势,帮助企业改进 AI 应用,促进实践经验的分享和复用,先“富”带后“富”,最终实现“共同富裕”。
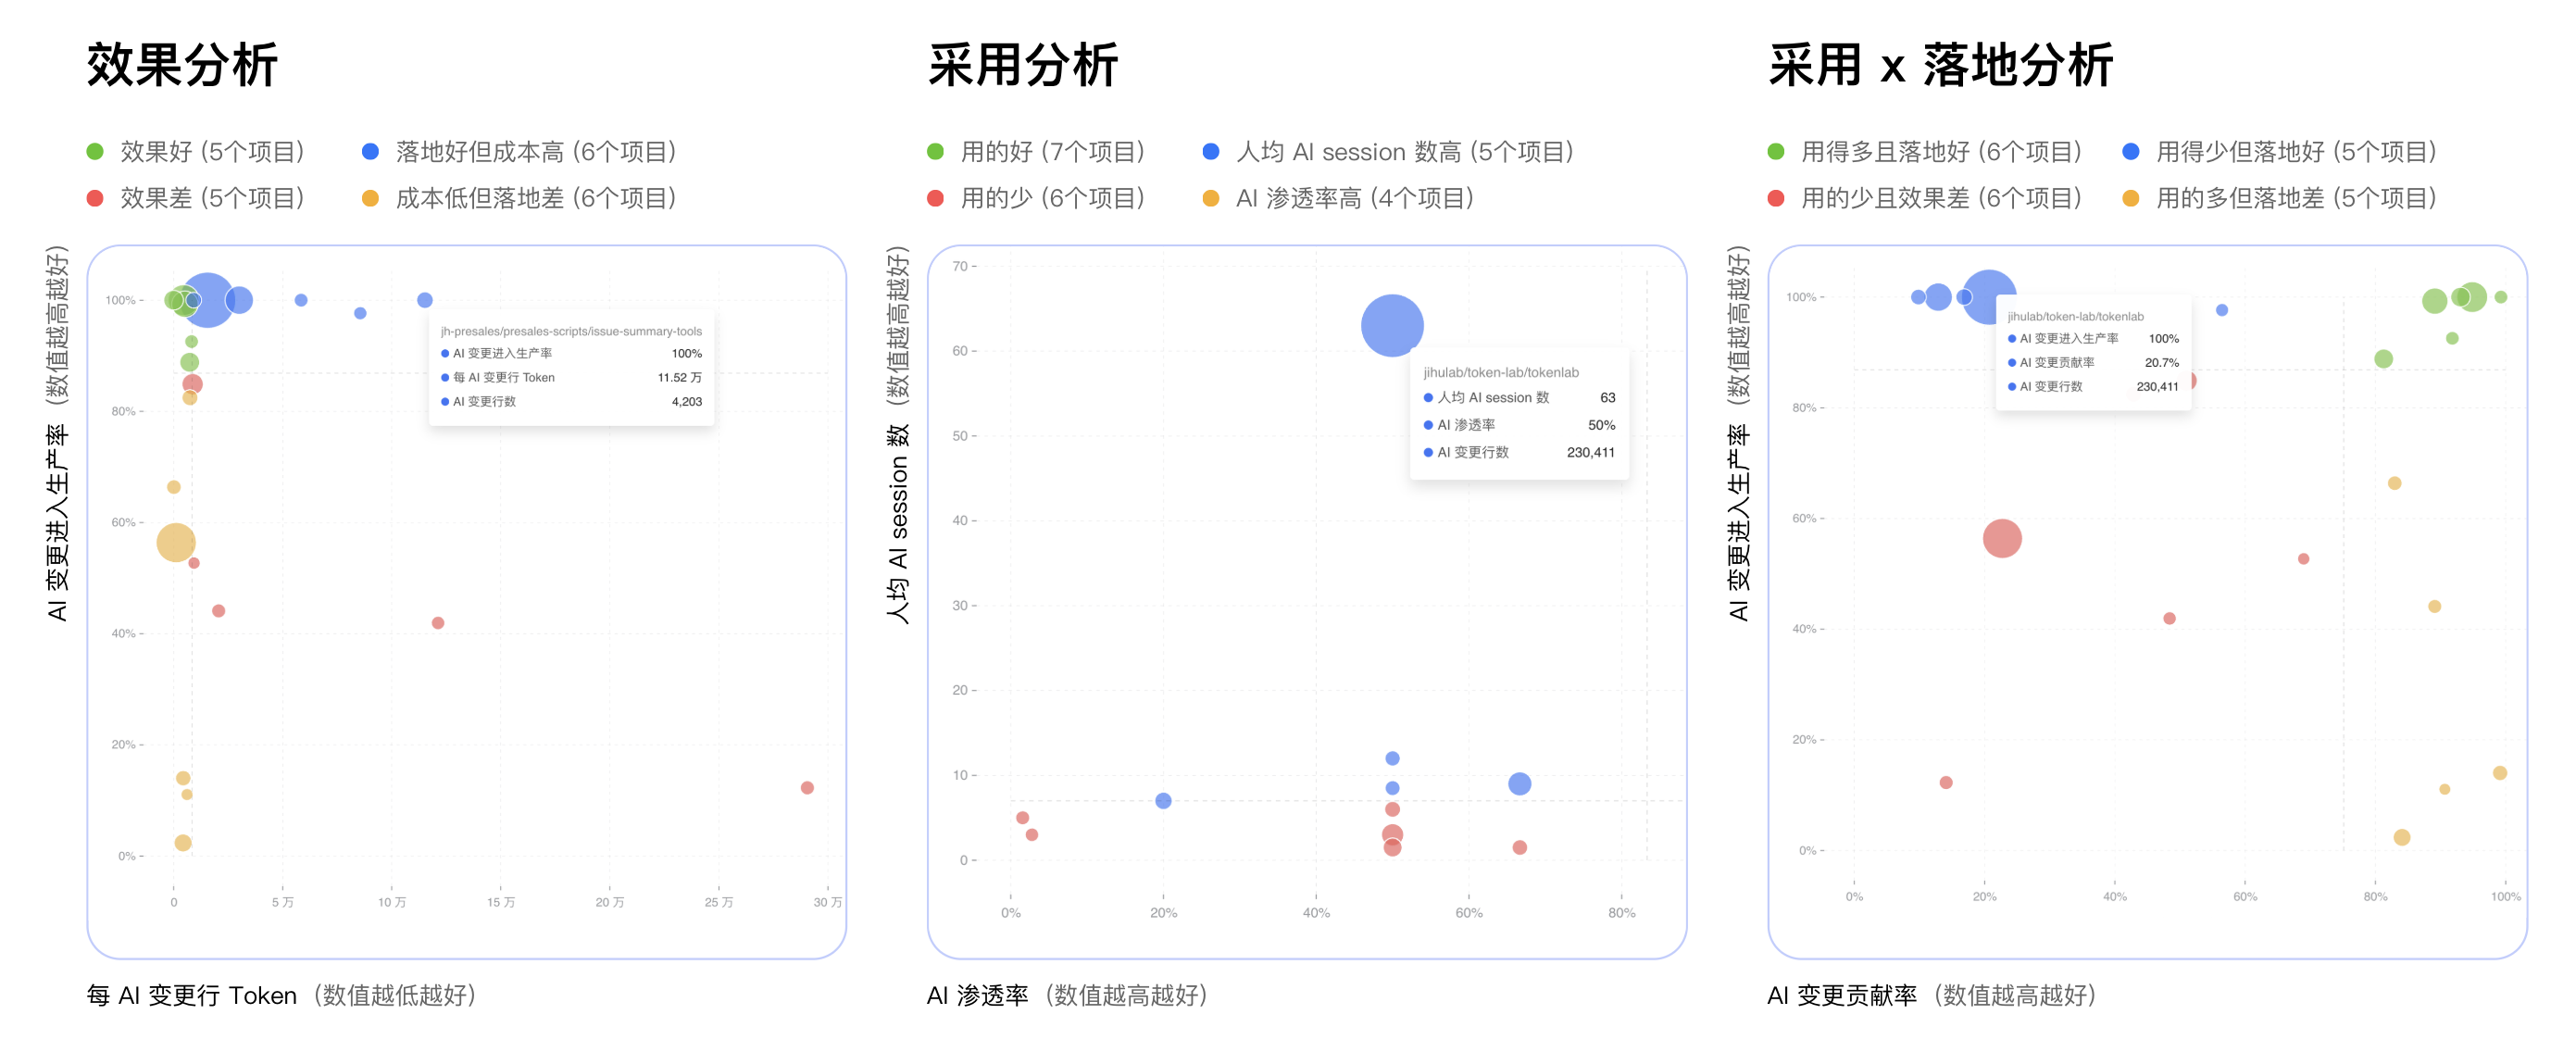
2. 开发核心问题:对抗不确定性
今年 7 月,我在 《1个人,3个月,500亿Token:我的 AI Native 产品开发实践》 这篇文章里也总结了一些阶段性的 AI Native 产品开发经验。
时至今日,我也早已没有了当初探索 Vibe Coding 的兴趣,一切归于日常和平静。不可否认,AI 带来了效率提升,但也有不少瓶颈和缺陷。虽然外部变化很快,可 AI 时代软件开发的核心问题依然没变——“对抗不确定性”。所以基于上篇文章,并结合近期实践,我提炼了一些 AI Native 产品开发过程中的个人经验,仅供参考。
2.1 构建适合自己的 Loop
Loop 的本质还是 SDLC,是软件开发的流程。需求、设计、开发、测试放到 Agent 中完成,开发者或产品经理做验收测试,最后交付客户试用或上线,再根据反馈继续改进。
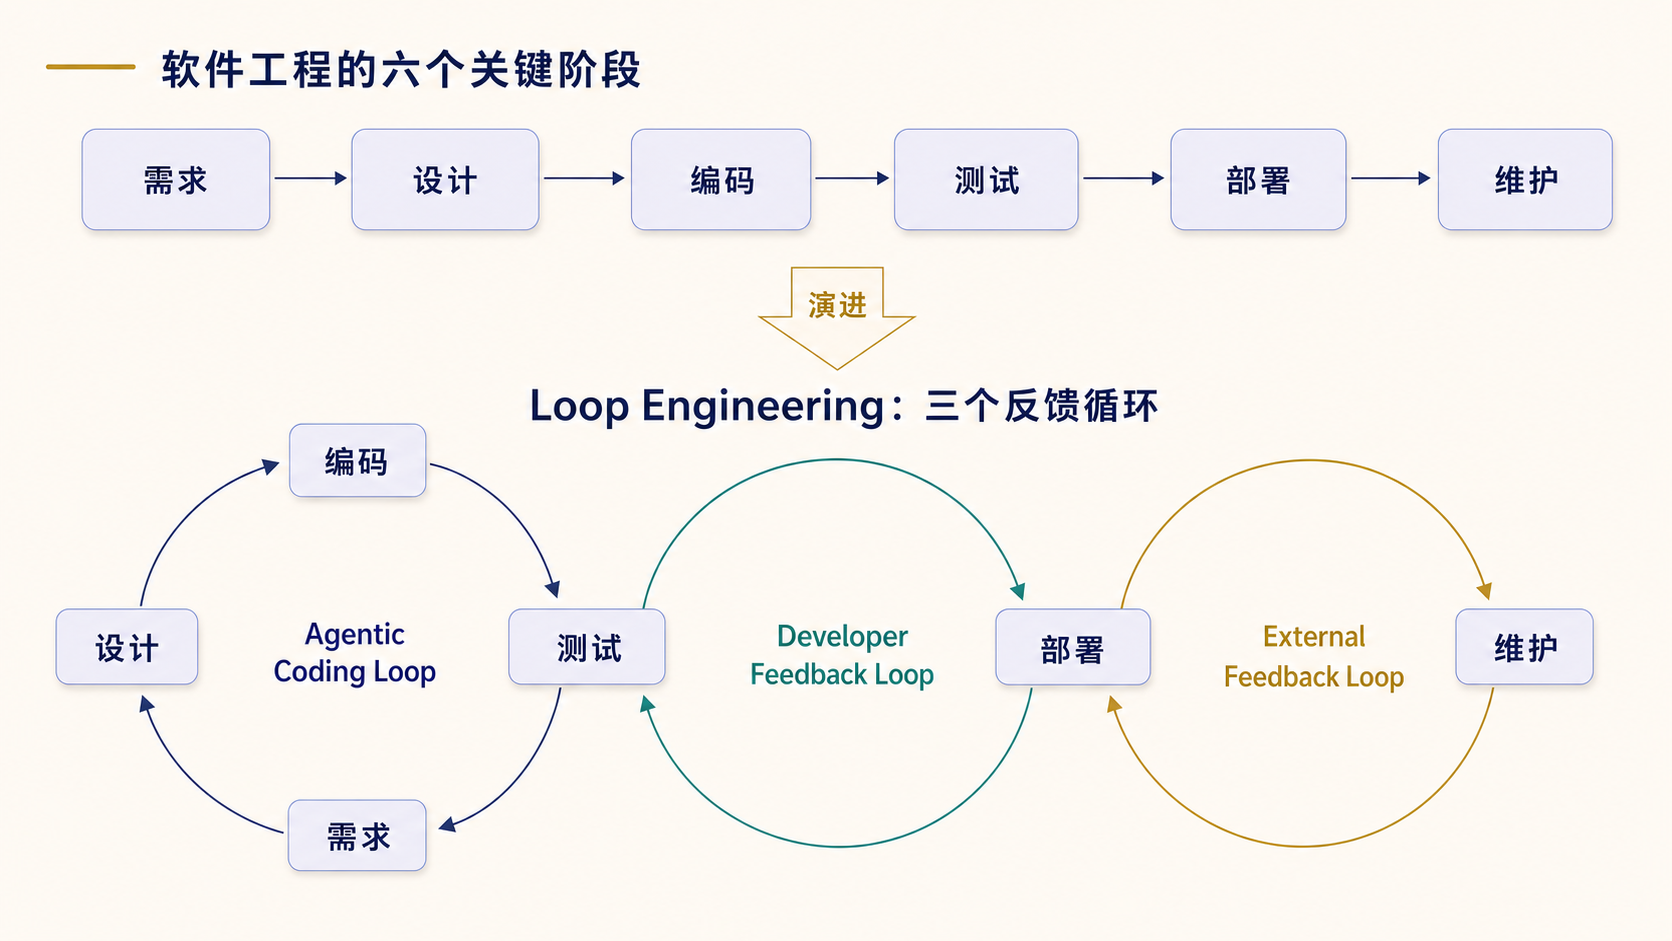
在这个流程里,AI 加快了方案生成、代码实现、评审和测试等工作。但业务需求是否合理,技术方案是否适用,产品是否符合用户预期,依然需要人的判断。AI 执行得再快,需求没有想清楚,关键问题没有确认,或者开发完成后没有及时验收和反馈,整个流程还是会受到影响。这些依赖人的环节,也会成为 Loop 的瓶颈。
所以我们要做的,就是加快这些 Loop,并尽量在前面的 Loop 中发现和解决问题。比如在需求和设计阶段发现偏差,在 Agentic Coding Loop 中通过评审和测试检查实现,减少带入人工验收和客户使用阶段的问题。这样才能在提高效率的同时,降低不确定性和后续返工的成本。
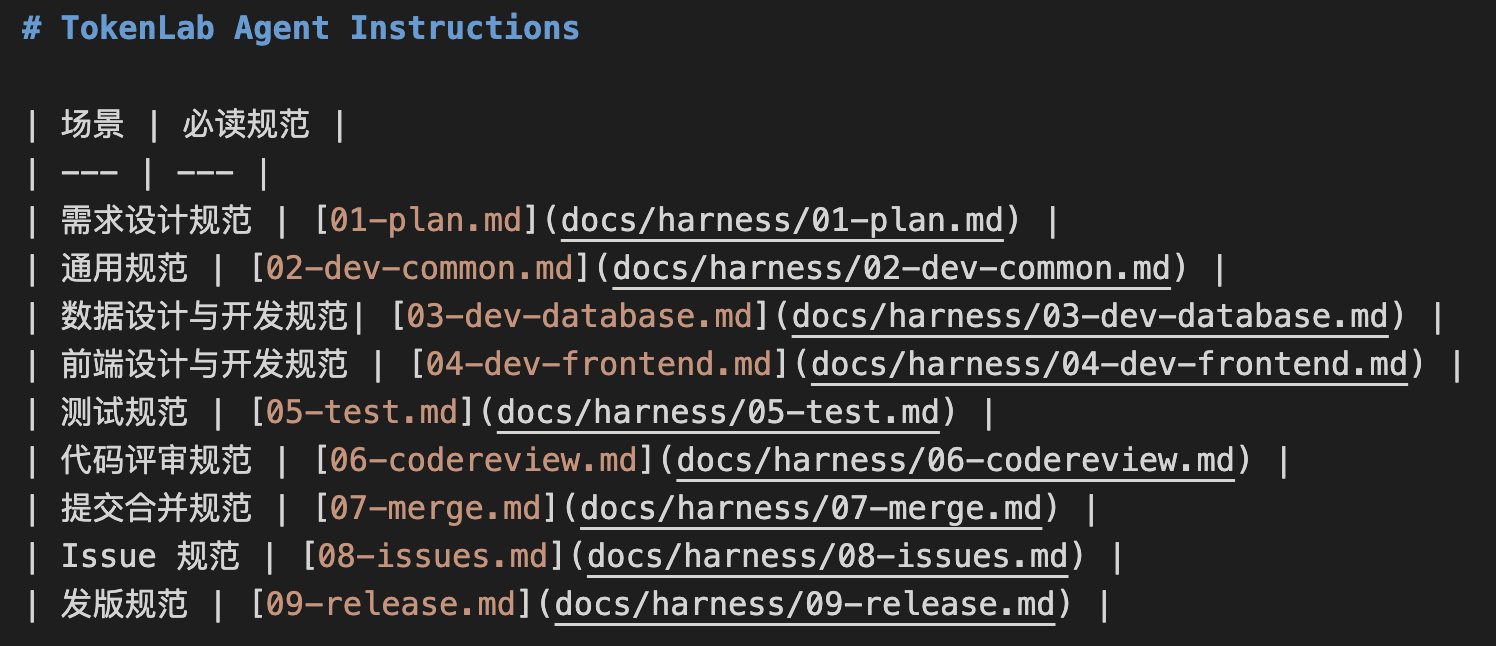
这就需要根据实际需要,选择并定制 Loop 框架,如 Superpowers。在此基础上,还要把实践中的经验沉淀到 Skill 或 AGENTS.md 中,让这些要求成为流程的一部分,逐步形成符合自己开发场景的 Loop。
2.2 Spec 的评审与版本控制
我在之前的文章中一再强调 Spec > Code。AI 可以根据你的想法生成一份看起来很完整的 Spec,但它对业务的理解是否正确,设计是否符合当前项目,都需要仔细评审。
需求理解有偏差,后面的开发任务就可能持续放大偏差。如果到了 Developer Feedback Loop 或 External Feedback Loop 才发现,那返工的成本就非常高了。所以在开发之前,需要把业务流程、边界条件和验收要求讨论清楚。另外,前端页面一定要有设计稿和开发规范,否则很难预判 AI 最后会做出什么样的界面。
我现在常用的方式是:
- AI 自评审:让 AI 从需求匹配、潜在冲突、过度设计、性能问题等维度检查 Spec。
- AI 交叉评审:换用其他 Agent 和模型,按照相同维度进行评审。比如我现在用 Claude Code 和 Opus 5.5 做 Spec 和 Plan,就让 Codex 和 GPT 6 Astra 来评审。
- 用户评审:让 AI 基于 Spec 绘制流程图,并列出需要用户确认或关注的关键问题。
- 用户提问:用户作为业务设计与技术管理人员,要针对这个需求提出核心问题让 AI 来回答。
Spec 和 Plan 也应该随代码一起做版本控制。它们记录了这个功能为什么这样设计,也是后续开发、评审和验收的依据。
2.3 把检查和约束固化为程序
使用 AI 做评审时,多追问一句“还有没有没考虑到的问题?”,它可能就又发现了新问题。这也是模型随机性的表现。反复评审能减少遗漏,但要消耗 Token,也无法保证把问题找全。所以对于已经明确的要求,应该尽可能用固化的程序来检查。
比如把业务规则和边界条件写成自动化测试,固定检查内容和通过条件,每次修改后重复运行,也能减少反复评审的 Token 消耗。但仅有单元测试远远不够,还需要 E2E 测试验证完整业务流程。让 AI 通过浏览器或客户端模拟用户操作,跑通主要流程,覆盖边界场景,不能只用 Mock 数据证明功能可用。
E2E 测试还要考虑运行环境。我遇到过本地 E2E 测试和人工验收都通过,打包成容器后,却因为 Nginx 配置和变量读取而出错的情况。所以实际部署环境下的 E2E 测试尤为重要,需要让 AI 在交付环境中再跑一轮,修复问题后补充测试用例。
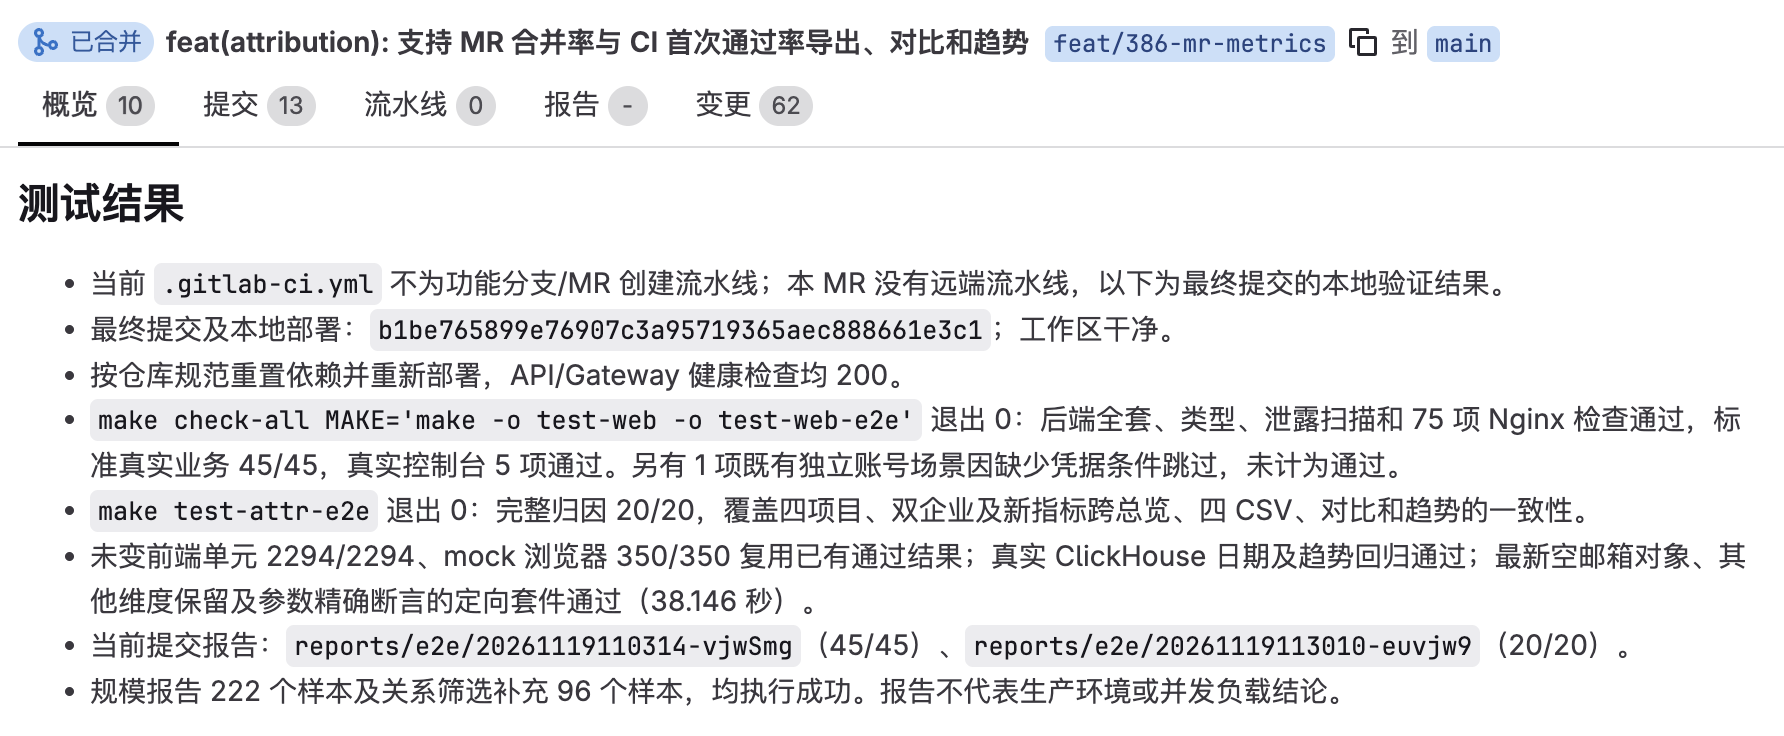
除了用测试验证业务功能,AGENTS.md 中的开发规则也可以用程序检查。比如用 Lint 检查编码规范,用脚本检查依赖限制,接入 CI 后将检查通过作为合并条件。提示词的可靠性远不如固化的程序,能转成程序检查的规则,都建议这样做。
2.4 人的价值:业务设计与技术管理
前面提到的需求讨论、Spec 评审、测试验收,都需要人参与。这也是我在使用 AI 开发产品时投入时间最多的地方。AI 能承担大量执行工作,人需要判断它的设计和实现有没有问题。
这就要求人既懂业务,也懂技术。比如在需要处理大量数据的场景中,你需要让 AI 关注并发问题;在有特殊业务规则的场景中,你需要主动提出关键流程和边界条件。这些问题如果你自己没有意识到,也不能指望 AI 每次都替你考虑周全。
验收时也是一样。AI 按照 Spec 实现了功能,测试也通过了,这个产品是否符合用户的实际要求?还是需要自己去使用,检查交互和业务流程,发现设计时没有考虑到的问题,再反馈给 AI 修改。人的业务理解和技术经验,会直接影响能发现哪些问题,以及最终交付的质量。
3. AI Native 组织与产品经理定位
最近看了不少 AI Native 组织转型的分享。比如李彦宏提出,未来岗位会逐渐收敛为 Builder 和 Seller,前者负责创造,后者侧重沟通和建立信任。特赞的范凌也分享了 Pod 跨职能小团队的实践:让一个小团队承担完整任务,减少跨部门的协调和资源等待。
这些探索的具体形式各不相同,我看到的共同方向是:精简、复合、高效。减少组织层级和工作交接,让一个人借助 AI 承担多个职能,围绕产品或项目组织团队,对最终交付负责。
我理解,这些调整也是为了让组织协作跟上 AI 带来的效率变化。一个功能很快就能开发出来,需求确认、资源协调、审批和交付却仍然需要长时间等待,臃肿的组织和流程就成了短板。Atlassian 的 2026 年团队调研也提到,个人执行速度加快后,评审、审批和协调决策可能跟不上新增的工作。AI 带来的局部提效,要通过职责和流程的调整,才能转化为整体提效。
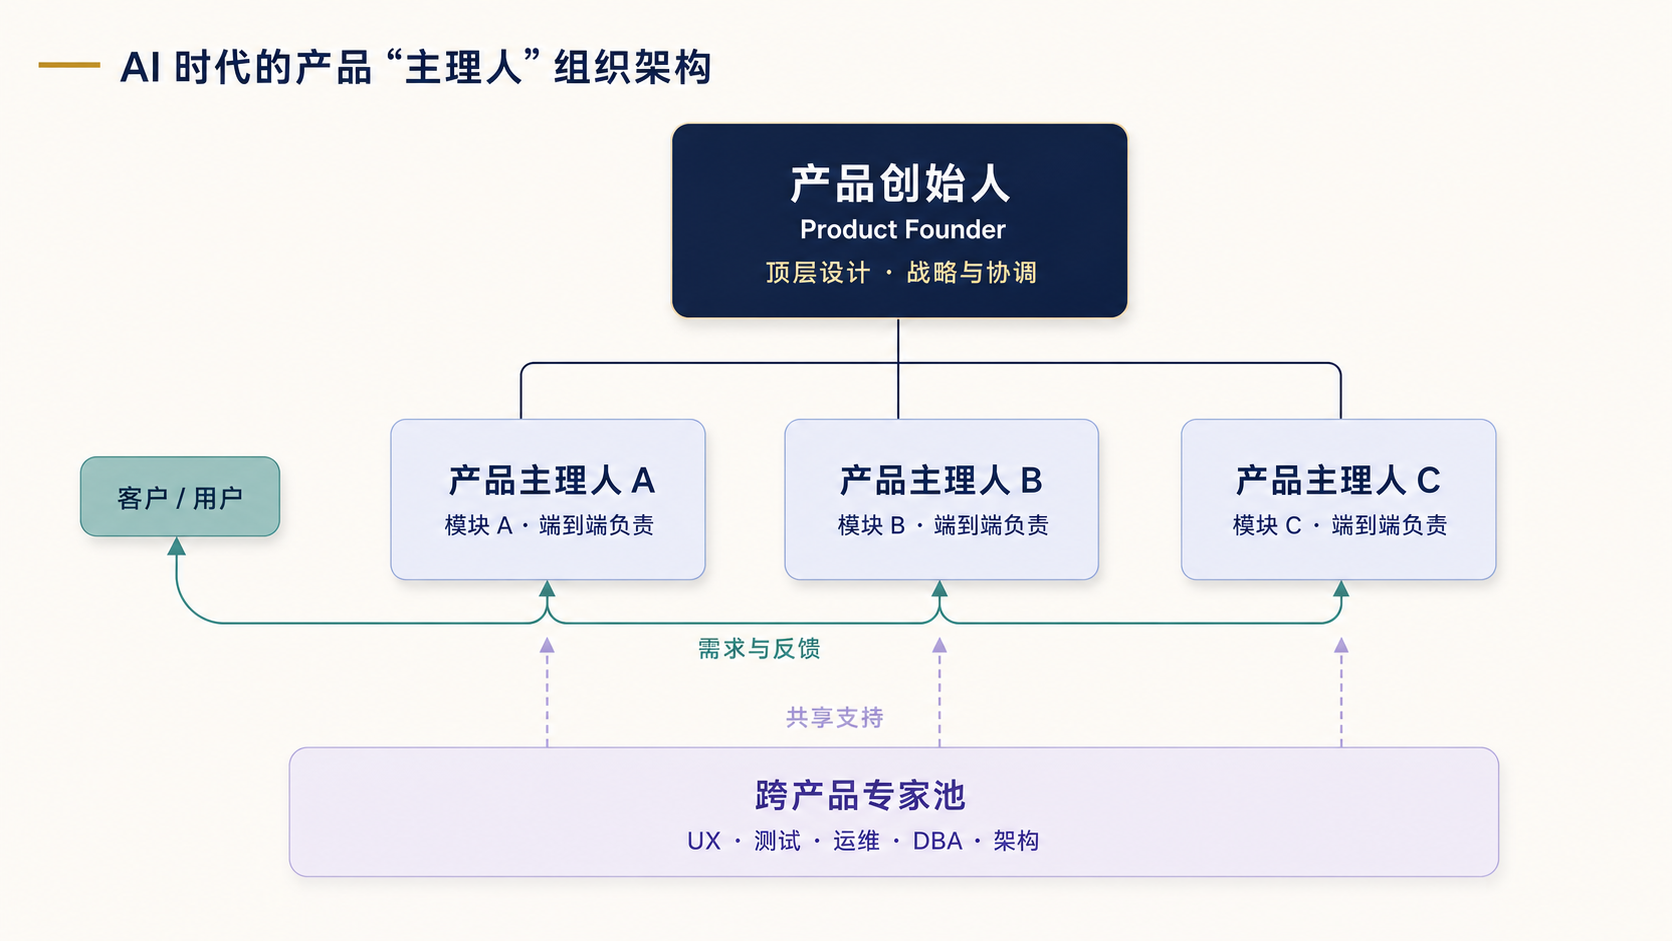
具体到产品经理,我更倾向于上一篇文章里提到的产品“主理人”模式:借助 AI,对一个产品或功能模块从需求到交付的全过程负责。他需要直接接触客户,理解业务,判断哪些问题值得解决,再完成产品设计并组织 AI 开发,通过实际使用和反馈验证效果。这就要求产品经理既懂业务,也具备技术判断能力。
产品初期,一个主理人可以先完成 MVP,交给用户验证。随着产品规模扩大,再由多个主理人分别负责不同模块,产品创始人关注整体方向和模块之间的关系。UX、架构、测试等专业问题,可以由跨产品、跨项目的专家提供支持。有相关专长的产品主理人,也可以为其他模块或项目提供支持。
TokenLab 经过半年的开发,并结合数千名用户超过 3 个月的试用反馈持续打磨,将于 11 月 26 日在深圳高交会上正式发布 1.0.0 版本。
我们在深圳国际会展中心(宝安)14 号展馆 B102,欢迎来现场见面交流,聊聊产品,也聊聊 AI 开发的实践。欢迎试用 TokenLab,期待你的反馈和建议。